Jev
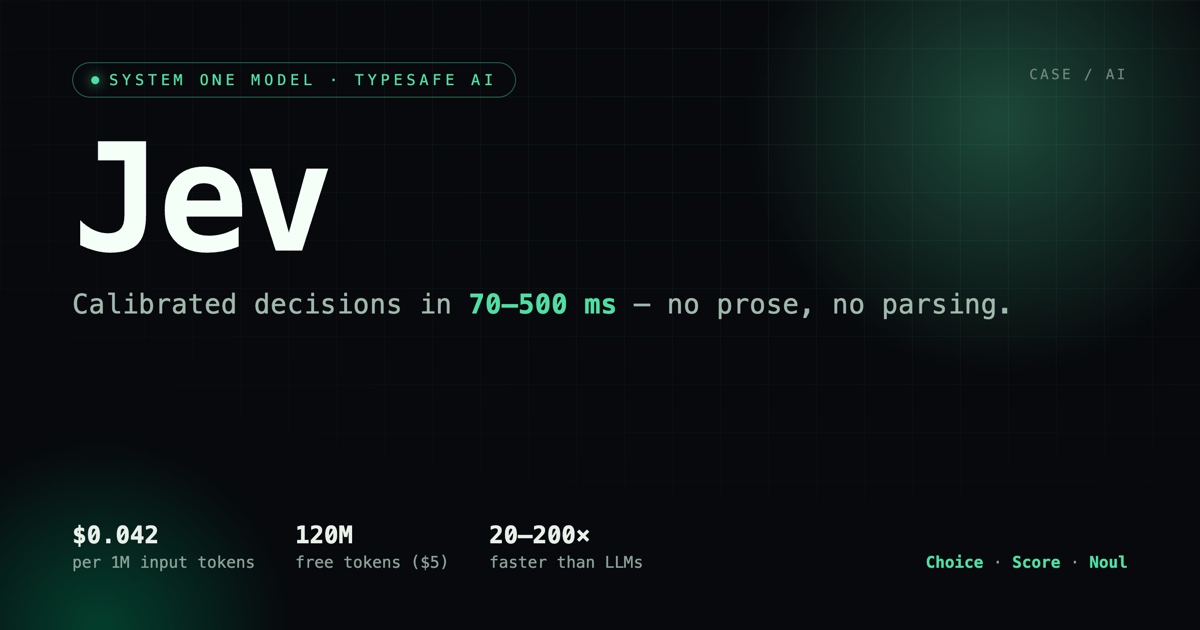
Le modèle non génératif System One de TypeSafe AI, Jev, renvoie des décisions typées et calibrées en 70–500 ms au lieu de texte ; il est désormais ouvert à tous avec 5 USD de crédit.
- maker
- TypeSafe AI
- founder
- Diogo Almeida (ex-OpenAI)
- latency
- 70–500 ms
- price
- 0,042 USD / 1 M tokens en entrée (sortie gratuite)
- free credit
- 5 USD ≈ 120 M tokens
- funding
- Tour d'amorçage de 40 M USD (DCVC)
- published
- 2026-09-20
- updated
- 2026-09-20
Ce que c'est
Jev est un modèle non génératif de TypeSafe AI qui refuse d'écrire de la prose. Ce n'est pas un LLM conversationnel : on lui fournit un état de programme et une ou plusieurs questions prédéfinies, et il renvoie une réponse typée — une option d'une liste, un score ou une probabilité entre 0 et 1 — accompagnée d'une note de confiance. TypeSafe appelle ces sorties des « décisions calibrées ».
L'entreprise a été cofondée par Diogo Almeida, ancien chercheur d'OpenAI qui a contribué à ChatGPT et à l'apprentissage par renforcement à partir du retour humain (RLHF). Après deux ans en mode furtif, TypeSafe a fait ses débuts le 15 septembre avec un tour d'amorçage de 40 millions de dollars mené par DCVC et Jev comme premier modèle. Après une liste d'attente, Jev est désormais ouvert à tous, avec 5 USD de crédit (environ 120 millions de tokens) pour chaque compte inscrit.
Proposition de valeur
Jev échange la génération libre contre des décisions fortement typées et parallèles :
- Des sorties typées, pas du texte : chaque réponse est un Choice (jusqu'à 255 options), un Score sur une échelle définie ou un Noul (une assertion booléenne exprimée sous forme de probabilité), avec distributions de probabilité complètes et scores de confiance. Pas de prompts JSON ni de parser de sortie.
- Évaluation en parallèle : toutes les questions d'une même requête partagent la même entrée, mais sont évaluées indépendamment et simultanément.
- Vitesse et coût : TypeSafe annonce une latence de bout en bout de 70–500 ms — 20 à 200 fois plus rapide que des LLM comparables — à 42 USD par milliard de tokens en entrée (0,042 USD par million), la sortie étant gratuite.
- Pas d'hallucination classique : comme l'espace de réponses est défini en amont, le modèle ne peut pas inventer de détails hors des options prédéfinies, même s'il peut toujours choisir la mauvaise option.
- Couche de décision en temps réel : dans un benchmark public Ably Pong, Jev a pris 47 décisions de jeu en 12 secondes, tandis que Gemini, Claude et GPT n'en ont pris que deux à trois sur la même période.
Ce qu'il peut remplacer
| Logiciel cible | Faisabilité | Verdict et contexte d'usage |
|---|---|---|
| Prompts de classification et de routage avec un LLM | Élevée | Remplace les prompts à schéma JSON par une sortie typée pour une fraction de la latence et du coût ; Vercel a rapporté un gain de 5–18x face au classifieur de sécurité ChatGPT Luna 5.6, avec une meilleure précision. |
| Classifieurs dédiés affinés (fine-tuning) | Modérée | Compétitif sur de nombreuses tâches de routage et de notation, mais les équipes perdent la maîtrise de l'architecture et des données d'entraînement exactes. |
| Dialogue, résumé ou génération ouverte | Faible | Jev ne produit pas de texte ; la saisie de texte dans les flux d'agents nécessite encore un petit modèle génératif en arrière-plan. |
Réalités et limites actuelles
- Il décide, il ne raisonne pas : Jev répond à des questions prédéfinies ; il ne s'explique pas et ne traite pas de tâches ouvertes.
- Une mauvaise réponse reste possible : contraindre l'espace de sortie évite les détails inventés, mais choisir une mauvaise option dans l'ensemble demeure un risque réel.
- Le développeur porte l'incertitude : comme l'a souligné Armin Ronacher, CTO d'Earendil, les équipes doivent décider quoi faire à 50 % de probabilité contre 95 %, ce qui déplace la gestion des hallucinations dans le code de l'application.
- Architecture non divulguée : TypeSafe n'a pas publié l'architecture exacte de Jev, et certains supposent qu'il adapte un modèle de base open source.
- Pression de capacité : la demande après le lancement public a brièvement dépassé la capacité et provoqué des ralentissements de l'API.
Verdict
Recommandation principale Traitez Jev comme une primitive de décision rapide et bon marché, pas comme un chatbot. Pour le routage, la notation, la modération et la sélection d'actions d'agents, il peut réduire coût et latence d'un ordre de grandeur — à condition que le développeur orchestre des questions explicites dans le code et définisse des seuils clairs pour agir selon une probabilité.
Une inférence moins chère change la fréquence à laquelle il vaut la peine d'appeler un modèle. Le nom de Jev vient du paradoxe de Jevons — quand une ressource devient moins chère, sa consommation totale augmente — et le pari est qu'une inférence quasi gratuite fera entrer l'intelligence dans d'innombrables micro-décisions qui ne justifiaient pas auparavant un appel à un LLM.
Cycle de vie et boucle d'itération
Jev se déploie en décomposant une décision métier en questions explicites orchestrées dans le code, plutôt qu'en espérant qu'un seul prompt gère tout.
| Étape | Modèle / outil utilisé |
|---|---|
| Conception de l'espace de décision (schémas Choice / Score / Noul) | Ensembles de questions et d'options définis par le développeur |
| Inférence de décision en temps réel | TypeSafe Jev |
| Orchestration, seuils et solutions de repli | Code applicatif (runners TypeScript / Python) |
| Étapes de texte libre (p. ex. saisir une ville) | Petit modèle génératif, appelé uniquement si nécessaire |
Métriques et monétisation
- Financement et lancement : tour d'amorçage de 40 M USD mené par DCVC, début public le 15 septembre.
- Prix : 0,042 USD par million de tokens en entrée, sortie gratuite ; les nouveaux comptes reçoivent 5 USD de crédit, soit environ 120 millions de tokens.
- Résultats rapportés : Vercel a rapporté un gain de 5–18x face à ChatGPT Luna 5.6 pour la classification de sécurité ; Bryo AI a constaté que Jev était 10–20x moins cher que Gemini pour classer des e-mails professionnels, avec une précision légèrement inférieure.
- Premiers usages : une équipe a filtré un flux de contenu de niche en évaluant huit critères sur trois jours de publications en deux secondes pour 0,007 USD ; des équipes d'analyse marketing ont branché Jev sur la Meta Ad Library pour suivre le cycle de vie des annonces et noter les scripts créatifs, avec un flux de travail 30x plus rapide pour moins de 3 USD.
- Monétisation : tarification à l'usage selon les tokens ; TypeSafe indique prévoir des modèles spécialisés par domaine.
Accueil de la communauté et débats clés
Le lancement a suscité de nombreux débats dans les communautés du développement et du design IA :
- Le routage de modèles comme killer app : Ronacher a soutenu que prédire si une requête nécessite un modèle de pointe est précieux, mais était prohibitif avec un LLM ; Jev rend le routage intelligent en temps réel économiquement viable.
- Non génératif contre génératif : les développeurs ont salué le déterminisme et la vitesse en parallèle, présentant Jev comme une couche de garde-fou pour les architectures agentiques plutôt qu'un remplacement des LLM.
- Qui gère l'incertitude : le compromis le plus cité est que contraindre les sorties renvoie les seuils de probabilité au développeur.
- Positionnement et hype : Almeida a déclaré qu'il ne considérait pas TypeSafe comme un laboratoire de pointe — « les principaux produits des laboratoires de pointe sont soit la peur, soit le hype. Je veux que notre principal produit soit l'intelligence ».
Sources
- [1]TypeSafe AI ConsoleTypeSafe AI
- [2]gregpr07 on X — jev-ultrafast computer-use agent decision layerX (formerly Twitter)
- [3]tamarajtran on X — near-instant token compression with JevX (formerly Twitter)
- [4]mdlahfir on X — dynamic model routing by task complexityX (formerly Twitter)
Cas similaires
- → KageExpérience
- → KillMyIdeaExpérience
- → AI Fishing GameExpérience